 آی تی گیم اخبار فناوری، تکنولوژی و بازی
رقابت میان شرکتهای بزرگ هوش مصنوعی در سال ۲۰۲۶ وارد مرحله تازهای شده است. پس از معرفی GPT-۶ Astra توسط OpenAI، حالا Anthropic با Claude Opus 5.5 تلاش کرده فاصله خود را در حوزههایی مانند برنامهنویسی عاملمحور، انجام وظایف حرفهای و کار با پروژههای پیچیده کاهش دهد. این دو مدل در حال حاضر در میان پیشرفتهترین مدلهای زبانی موجود قرار دارند و مقایسه آنها فقط به تعداد پارامترها یا یک امتیاز بنچمارک محدود نمیشود.
Claude Opus ۵.۵ در ۲۲ سپتامبر ۲۰۲۶ معرفی شد و نخستین مدل خانواده Claude ۵.۵ محسوب میشود. Anthropic میگوید این مدل در بسیاری از کارها به سطح Claude Fable ۵.۱ میرسد، اما هزینه اجرای آن نسبت به Opus ۵ حدود ۴۰ درصد کمتر شده است. در سوی دیگر، OpenAI، GPT-۶ Astra را بهعنوان پرچمدار نسل ششم مدلهای GPT معرفی کرده و روی توانایی آن در استفاده از کامپیوتر، برنامهنویسی، پژوهش علمی، امنیت سایبری و انجام وظایف حرفهای تأکید دارد.
اما در عمل Claude Opus ۵.۵ و GPT-۶ Astra چه تفاوتی با یکدیگر دارند؟ کدامیک برای برنامهنویسی مناسبتر است، در انجام کارهای طولانی چه تفاوتی دارند و هزینه استفاده از آنها چقدر است؟
Claude Opus ۵.۵ و GPT-۶ Astra چه هستند؟
Claude Opus ۵.۵ جدیدترین مدل رده Opus شرکت Anthropic است. این مدل برای کارهای پیچیده و چندمرحلهای طراحی شده و یکی از تمرکزهای اصلی آن، انجام وظایف طولانی با کمک قابلیتهای عاملمحور است.
Anthropic در معرفی Opus ۵.۵ روی توانایی آن برای کار با کدبیسهای بزرگ، مهاجرت پروژهها، ممیزی نرمافزار و اجرای وظایف پیچیده تأکید کرده است. این شرکت همچنین اعلام کرده که Opus ۵.۵ در بعضی آزمونهای برنامهنویسی عاملمحور توانسته با هزینه بسیار پایینتری به عملکرد GPT-۶ Astra نزدیک شود.
GPT-۶ Astra نیز مدل پرچمدار نسل ششم OpenAI است. این مدل از ابتدا با تمرکز روی استدلال پیشرفته، استفاده از ابزارها، کار با کامپیوتر و اجرای وظایف حرفهای توسعه یافته است. OpenAI میگوید Astra در زمینههایی مانند مهندسی نرمافزار، استفاده از مرورگر، علوم، امنیت سایبری و انجام وظایف حرفهای به سطح جدیدی از عملکرد رسیده است.
بنابراین، هر دو مدل صرفاً برای پاسخگویی به پرسشهای متنی طراحی نشدهاند و هدف اصلی آنها انجام وظایف پیچیدهتر و نزدیکتر به کار یک دستیار حرفهای است.
 مقایسه مشخصات Claude Opus ۵.۵ و GPT-۶ Astra
 مقایسه مشخصات Claude Opus ۵.۵ و GPT-۶ Astra
| ویژگی | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|
| شرکت سازنده | Anthropic | OpenAI |
| نسل | Claude 5.5 | GPT-6 |
| جایگاه | مدل رده Opus | مدل پرچمدار GPT-۶ |
| تمرکز اصلی | استدلال، کدنویسی و وظایف عاملمحور | استدلال، استفاده از کامپیوتر و کار حرفهای |
| پنجره زمینه | حدود ۱ میلیون توکن | حدود ۱.۰۵ میلیون توکن |
| حداکثر خروجی | تا ۱۲۸ هزار توکن | تا ۱۲۸ هزار توکن |
| مدل API | claude-opus-5-5 | gpt-6-astra |
| قیمت ورودی API | ۴ دلار به ازای هر میلیون توکن | ۱۰ دلار به ازای هر میلیون توکن |
| قیمت خروجی API | ۲۰ دلار به ازای هر میلیون توکن | ۵۰ دلار به ازای هر میلیون توکن |
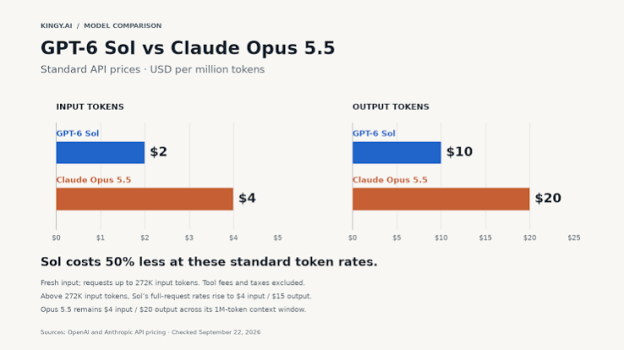
تفاوت قیمت در API قابل توجه است. قیمت استاندارد GPT-۶ Astra برای هر میلیون توکن ورودی ۱۰ دلار و برای خروجی ۵۰ دلار اعلام شده است، در حالی که Claude Opus ۵.۵ با قیمت ۴ دلار برای ورودی و ۲۰ دلار برای خروجی عرضه شده است.
البته قیمت هر توکن بهتنهایی مشخص نمیکند یک مدل برای یک پروژه خاص چقدر هزینه خواهد داشت. تعداد توکنهای مصرفشده، تعداد دفعات فراخوانی مدل، استفاده از کش و میزان کاری که مدل برای رسیدن به نتیجه انجام میدهد نیز روی هزینه نهایی تأثیر دارند.
رقابت اصلی در برنامهنویسی
برنامهنویسی یکی از مهمترین میدانهای رقابت میان مدلهای جدید هوش مصنوعی است. مدلهای نسل جدید دیگر فقط قطعه کد تولید نمیکنند؛ بلکه میتوانند یک پروژه را بررسی کنند، فایلهای مختلف را تغییر دهند، تست اجرا کنند، خطاها را پیدا کنند و در چند مرحله راهحل را اصلاح کنند.
Anthropic در معرفی Claude Opus ۵.۵ روی همین قابلیت تمرکز زیادی داشته است.
این شرکت میگوید Opus ۵.۵ برای کارهایی مانند مهاجرت کدبیسهای بزرگ و ممیزی پروژههای گسترده عملکرد بسیار خوبی دارد. در یکی از نمونههای اعلامشده توسط Anthropic، یک آزمایشکننده توانسته با Opus ۵.۵ یک کدبیس ۲۰۰ هزار خطی را در کمتر از سه ساعت بررسی و اصلاح کند؛ در حالی که Opus ۵ برای همان کار بیش از ۲۰ ساعت زمان و حدود ۲.۵ برابر توکن بیشتر مصرف کرده بود.
Anthropic همچنین در آزمون FrontierCode اعلام کرده که Opus ۵.۵ در سطح پیشفرض به امتیاز ۵۴.۶ درصد رسیده است؛ در همین مقایسه، بالاترین امتیاز گزارششده برای GPT-۶ Astra برابر با ۵۳.۳ درصد بوده است.
با این حال، این اعداد باید با احتیاط تفسیر شوند. تنظیمات اجرای مدل، سطح تلاش استدلالی، نسخه آزمون و هزینه هر وظیفه روی نتیجه تأثیر دارند و یک بنچمارک بهتنهایی نمیتواند عملکرد واقعی یک مدل را در تمام پروژههای نرمافزاری مشخص کند.
 GPT-۶ Astra در برنامهنویسی و مهندسی نرمافزار
 GPT-۶ Astra در برنامهنویسی و مهندسی نرمافزار
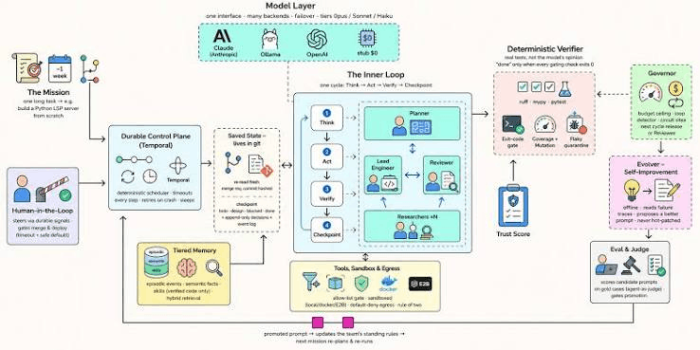
OpenAI نیز GPT-۶ Astra را با تمرکز ویژه بر مهندسی نرمافزار معرفی کرده است. این شرکت Astra را برای انجام وظایف پیچیده برنامهنویسی، کار با ابزارها و اجرای فرآیندهای چندمرحلهای طراحی کرده است.
یکی از تفاوتهای مهم در رویکرد دو شرکت، تأکید OpenAI بر استفاده گسترده از مدل در محیطهای مختلف است. Astra میتواند در کنار API و ChatGPT در محیطهایی قرار بگیرد که مدل باید با فایلها، ابزارها، مرورگر و محیط کامپیوتری تعامل داشته باشد.
در آزمون Terminal-Bench ۴.۰ نیز Anthropic اعلام کرده که Opus ۵.۵ با سطح تلاش پیشفرض توانسته عملکردی در سطح GPT-۶ Astra ارائه کند، در حالی که هزینه هر وظیفه آن به گفته این شرکت حدود ۴۰ درصد هزینه Astra بوده است.
این موضوع یکی از مهمترین نقاط رقابت جدید است: فقط کیفیت پاسخ مهم نیست؛ هزینه رسیدن به پاسخ نیز اهمیت دارد.
کدام مدل در انجام وظایف طولانی بهتر عمل میکند؟
یکی از تفاوتهای مهم مدلهای جدید با نسلهای قدیمی، توانایی مدیریت وظایف طولانی است.
برای مثال، یک کاربر ممکن است به جای درخواست «یک تابع برای ورود کاربران بنویس»، از مدل بخواهد یک پروژه قدیمی را بررسی کند، ساختار آن را تغییر دهد، خطاهای احتمالی را پیدا کند و تستها را نیز اجرا کند.
در چنین شرایطی، مدل باید بتواند وضعیت پروژه را در طول مراحل مختلف حفظ کند و در صورت شکست یک مرحله، مسیر دیگری را امتحان کند.
Claude Opus ۵.۵ در همین حوزه تمرکز زیادی دارد. Anthropic اعلام کرده که این مدل برای کارهای طولانی مانند مهاجرت کدبیس و ممیزی پروژههای بزرگ بهینه شده است.
GPT-۶ Astra نیز در معرفی رسمی خود بر انجام وظایف چندمرحلهای و استفاده از کامپیوتر تأکید دارد. OpenAI برای Astra آزمونهایی در زمینه استفاده از کامپیوتر، مرور وب و انجام وظایف حرفهای ارائه کرده است.
در نتیجه، تفاوت اصلی این دو مدل را نمیتوان فقط با «طول کانتکست» توضیح داد. کیفیت مدیریت وضعیت، توانایی استفاده از ابزارها، برنامهریزی و بررسی نتیجه نیز در پروژههای طولانی اهمیت زیادی دارند.
عملکرد در استفاده از کامپیوتر
توانایی کنترل محیط کامپیوتری یکی از حوزههایی است که GPT-۶ Astra در آن مورد توجه قرار گرفته است.
OpenAI برای Astra نتایج مختلفی در آزمونهای استفاده از کامپیوتر منتشر کرده است. برای نمونه، این مدل در آزمون OSWorld ۲.۰ به امتیاز ۷۲.۶ درصد رسیده و در ScreenSpot-Pro نیز امتیاز ۹۲.۷ درصد را ثبت کرده است.
این نوع آزمونها با تولید متن ساده تفاوت دارند. مدل باید عناصر موجود روی صفحه را تشخیص دهد، محل مناسب برای کلیک را پیدا کند، مراحل مختلف را دنبال کند و در نهایت یک کار مشخص را به پایان برساند.
Claude Opus ۵.۵ نیز قابلیتهای عاملمحور و استفاده از ابزارها را هدف قرار داده است، اما بخش قابل توجهی از دادههای رسمی Anthropic درباره Opus ۵.۵ روی برنامهنویسی و وظایف حرفهای متمرکز شده است.
بنابراین، برای مقایسه استفاده از کامپیوتر، بهتر است نتایج آزمونهای یکسان و با شرایط یکسان بررسی شوند؛ نه اینکه نتایج منتشرشده توسط دو شرکت را مستقیماً کنار هم قرار دهیم.
استدلال و کارهای حرفهای
GPT-۶ Astra برای انجام وظایف حرفهای نیز طراحی شده است. OpenAI در ارزیابیهای خود Astra را روی حوزههایی مانند تحلیل داده، طراحی، اتوماسیون و کارهای تخصصی آزمایش کرده است.
در سوی دیگر، Anthropic برای Claude Opus ۵.۵ به ارزیابی GDPval-AA اشاره کرده است؛ آزمونی که عملکرد مدلها را روی کارهای حرفهای در ۴۴ شغل بررسی میکند.
طبق داده منتشرشده توسط Anthropic، Opus ۵.۵ در این آزمون در سطح تلاش حداکثری به امتیاز ۱۸۴۶ Elo رسیده است.
این نوع آزمونها نشان میدهند رقابت مدلهای هوش مصنوعی دیگر فقط به پاسخگویی به سؤالات عمومی محدود نیست. شرکتها تلاش میکنند مدلهایی بسازند که بتوانند بخشی از فرآیندهای واقعی کاری را نیز انجام دهند.
 هزینه استفاده؛ یکی از مهمترین تفاوتها
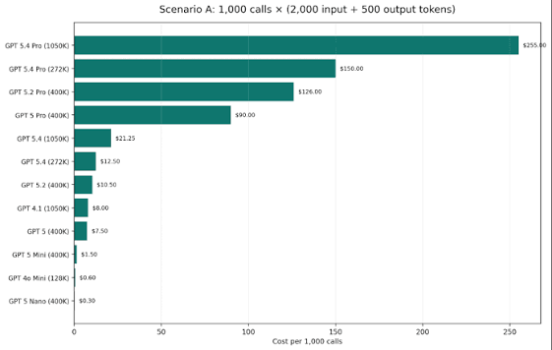 هزینه استفاده؛ یکی از مهمترین تفاوتها
در API، Claude Opus ۵.۵ اختلاف قیمت قابل توجهی با GPT-۶ Astra دارد.
قیمت استاندارد اعلامشده برای Claude Opus ۵.۵:
- ورودی: ۴ دلار برای هر میلیون توکن
- خروجی: ۲۰ دلار برای هر میلیون توکن
قیمت استاندارد GPT-۶ Astra:
- ورودی: ۱۰ دلار برای هر میلیون توکن
- خروجی: ۵۰ دلار برای هر میلیون توکن
در نتیجه، استفاده مستقیم از API Opus ۵.۵ از نظر قیمت هر توکن ارزانتر است.
اما برای پروژههای عاملمحور، قیمت هر توکن تنها معیار کافی نیست. اگر یک مدل برای تکمیل یک کار به توکنهای بسیار بیشتری نیاز داشته باشد یا چندین بار ابزارها را فراخوانی کند، هزینه نهایی میتواند با قیمت اسمی متفاوت باشد.
به همین دلیل Anthropic در معرفی Opus ۵.۵ بیشتر روی هزینه به ازای هر وظیفه تأکید کرده است، نه فقط قیمت هر میلیون توکن.
Claude Opus ۵.۵ در برابر GPT-۶ Astra؛ جدول مقایسه
| معیار | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|
| برنامهنویسی عاملمحور | تمرکز بسیار زیاد | تمرکز بسیار زیاد |
| کار با کدبیسهای بزرگ | تمرکز ویژه | پشتیبانی گسترده |
| استفاده از کامپیوتر | دارد | یکی از محورهای اصلی |
| کار حرفهای | عملکرد بالا در آزمونهای اعلامشده | عملکرد بالا در آزمونهای اعلامشده |
| پنجره زمینه | حدود ۱ میلیون توکن | حدود ۱.۰۵ میلیون توکن |
| حداکثر خروجی | ۱۲۸ هزار توکن | ۱۲۸ هزار توکن |
| قیمت ورودی API | ۴ دلار / میلیون توکن | ۱۰ دلار / میلیون توکن |
| قیمت خروجی API | ۲۰ دلار / میلیون توکن | ۵۰ دلار / میلیون توکن |
| تمرکز مهم در معرفی | کدنویسی و وظایف طولانی | استدلال، کامپیوتر و کار حرفهای |
این جدول به معنای انتخاب یک مدل بهعنوان برنده کلی نیست؛ زیرا کاربرد واقعی مدل میتواند نتیجه مقایسه را تغییر دهد.
آیا Claude Opus ۵.۵ جای GPT-۶ Astra را میگیرد؟
معرفی Claude Opus ۵.۵ نشان میدهد Anthropic قصد ندارد رقابت در بالاترین سطح بازار مدلهای هوش مصنوعی را به OpenAI واگذار کند.
Opus ۵.۵ در برخی ارزیابیهای منتشرشده توسط Anthropic عملکردی همسطح یا بالاتر از GPT-۶ Astra نشان میدهد، در حالی که Anthropic روی هزینه پایینتر اجرای وظایف تأکید دارد.
از طرف دیگر، GPT-۶ Astra نیز مجموعه گستردهای از قابلیتها را در اختیار دارد و OpenAI در معرفی آن نتایج بالایی در استفاده از کامپیوتر، مهندسی نرمافزار، علوم و وظایف حرفهای ارائه کرده است.
نکته مهم این است که هیچکدام از این دادهها بهتنهایی نمیتوانند ثابت کنند یک مدل در تمام کاربردها بهتر از دیگری است.
برای مثال، ممکن است یک مدل در مهاجرت یک کدبیس بزرگ عملکرد بسیار خوبی داشته باشد، اما در یک وظیفه متفاوت مانند کنترل رابط کاربری یا تحلیل داده نتیجه متفاوتی ارائه کند.
برای برنامهنویسان چه معنایی دارد؟
رقابت Opus ۵.۵ و Astra برای توسعهدهندگان اهمیت ویژهای دارد؛ زیرا مدلهای جدید بهتدریج از ابزارهای تکمیل کد به دستیارهای فعال توسعه نرمافزار تبدیل میشوند.
در گذشته، کاربر معمولاً بخشی از کد را به مدل میداد و پاسخ دریافت میکرد. اکنون مدل میتواند پروژه را بررسی کند، فایلهای مختلف را تغییر دهد، تست اجرا کند، خروجی را تحلیل کند و در صورت نیاز اصلاحات بیشتری انجام دهد.
این تغییر باعث شده معیارهایی مانند موارد زیر اهمیت بیشتری پیدا کنند:
- دقت تغییرات کد
- توانایی درک کل پروژه
- مدیریت وظایف چندمرحلهای
- اجرای صحیح تستها
- تشخیص خطا
- توانایی اصلاح اشتباهات قبلی
- تعداد توکن مصرفی
- هزینه نهایی هر وظیفه
Claude Opus ۵.۵ و GPT-۶ Astra هر دو دقیقاً در همین مسیر حرکت میکنند.
رقابت بعدی چگونه خواهد بود؟
عرضه Opus ۵.۵ و GPT-۶ Astra نشان میدهد رقابت مدلهای پیشرفته هوش مصنوعی دیگر فقط درباره بالاترین امتیاز در یک بنچمارک نیست.
شرکتها اکنون همزمان روی چند معیار رقابت میکنند:
هوش و دقت ← استفاده از ابزارها ← اجرای مستقل وظایف ← سرعت ← هزینه ← ایمنی
این روند میتواند به نفع کاربران و توسعهدهندگان باشد؛ زیرا مدلهای قدرتمندتر با هزینه پایینتر، امکان استفاده از هوش مصنوعی عاملمحور را برای پروژههای بیشتری فراهم میکنند.
از طرف دیگر، افزایش توانایی مدلها باعث میشود کیفیت کنترل ابزارها، محدودیت دسترسی و سازوکارهای ایمنی اهمیت بیشتری پیدا کند. هرچه مدل بتواند کارهای بیشتری را بدون دخالت مستقیم انسان انجام دهد، خطای یک تصمیم اشتباه نیز میتواند پیامد بزرگتری داشته باشد.
 جمعبندی
 جمعبندی
Claude Opus ۵.۵ و GPT-۶ Astra نماینده دو رویکرد بسیار نزدیک در نسل جدید مدلهای هوش مصنوعی هستند. هر دو مدل برای فراتر رفتن از چت ساده و انجام وظایف پیچیده، چندمرحلهای و حرفهای ساخته شدهاند.
Claude Opus ۵.۵ تمرکز ویژهای روی برنامهنویسی عاملمحور، کار با کدبیسهای بزرگ و کاهش هزینه اجرای وظایف دارد. Anthropic همچنین در برخی آزمونهای منتشرشده، عملکرد Opus ۵.۵ را در سطح یا بالاتر از GPT-۶ Astra گزارش کرده است.
GPT-۶ Astra نیز با تمرکز گسترده روی استدلال، استفاده از کامپیوتر، مهندسی نرمافزار، علوم و وظایف حرفهای عرضه شده و OpenAI مجموعهای از نتایج قوی را برای آن منتشر کرده است.
در نهایت، مقایسه این دو مدل را نمیتوان با یک عدد یا یک عنوان «برنده» تمام کرد. نوع کار، ابزارهای موردنیاز، هزینه، میزان خودکارسازی و کیفیت خروجی نهایی تعیین میکنند که هر مدل برای یک پروژه مشخص چه عملکردی ارائه دهد.
رقابت واقعی میان Claude و GPT نیز احتمالاً از اینجا به بعد کمتر درباره تولید بهترین پاسخ متنی و بیشتر درباره این خواهد بود که کدام مدل میتواند یک کار واقعی را با دقت بیشتر، دخالت انسانی کمتر و هزینه پایینتر به پایان برساند.