 آی تی گیم اخبار فناوری، تکنولوژی و بازی
بازار شتابدهندههای هوش مصنوعی در سال ۲۰۲۶ وارد مرحلهای شده که دیگر فقط قدرت خام پردازشی تعیینکننده نیست. با افزایش هزینه ساخت دیتاسنترهای AI، مصرف برق، قیمت حافظه HBM و هزینه اجرای مدلهای بزرگ، شرکتها بیش از گذشته به یک سؤال مهم توجه میکنند: برای تولید هر مقدار مشخصی خروجی هوش مصنوعی، کدام سختافزار هزینه کمتری دارد؟
در این رقابت، NVIDIA با معماری Blackwell و Blackwell Ultra همچنان یکی از مهمترین تأمینکنندگان بازار است، AMD با خانواده Instinct MI350 تلاش میکند هزینه و انعطافپذیری بیشتری ارائه دهد و Google با TPUهای اختصاصی خود، بهخصوص نسل هفتم Ironwood، مدل متفاوتی از رقابت را دنبال میکند.
بنابراین «جنگ قیمتی» در بازار چیپهای AI الزاماً به معنی کاهش مستقیم قیمت یک تراشه نیست. رقابت اصلی بیشتر بر سر هزینه هر توکن، عملکرد به ازای هر دلار، مصرف انرژی، مقدار حافظه و هزینه کل مالکیت سیستم شکل گرفته است.
چرا جنگ قیمتی چیپهای هوش مصنوعی شروع شده است؟
در نسلهای اولیه شتابدهندههای هوش مصنوعی، مهمترین معیار این بود که یک GPU چه مقدار توان پردازشی دارد. اما با گسترش مدلهای زبانی بزرگ، استدلال چندمرحلهای و سرویسهای AI که میلیونها کاربر دارند، اقتصاد اجرای مدل اهمیت بسیار بیشتری پیدا کرده است.
یک دیتاسنتر ممکن است هزاران شتابدهنده را بهصورت شبانهروزی اجرا کند. در چنین مقیاسی، حتی تفاوت نسبتاً کوچک در هزینه اجرای هر میلیون توکن میتواند در طول سال به اختلاف بسیار بزرگی در هزینه تبدیل شود.
به همین دلیل شرکتها اکنون به معیارهایی مانند اینها نگاه میکنند:
- هزینه هر میلیون توکن
- تعداد توکن پردازششده در ثانیه
- مصرف برق به ازای کار انجامشده
- مقدار حافظه HBM
- پهنای باند حافظه
- هزینه خرید یا اجاره سرور
- هزینه شبکه و ارتباط بین شتابدهندهها
- هزینه نرمافزار
- میزان استفاده واقعی از سختافزار
- هزینه مهاجرت نرمافزار از یک پلتفرم به پلتفرم دیگر
در نتیجه ممکن است تراشهای روی کاغذ ارزانتر باشد، اما اگر نرمافزار یا شبکه آن باعث کاهش بهرهوری شود، در نهایت هزینه بیشتری برای شرکت ایجاد کند.
 NVIDIA؛ رقابت با کاهش هزینه واقعی، نه لزوماً قیمت تراشه
 NVIDIA؛ رقابت با کاهش هزینه واقعی، نه لزوماً قیمت تراشه
NVIDIA در این بازار موقعیت متفاوتی دارد. این شرکت فقط یک GPU نمیفروشد؛ بلکه مجموعهای از GPU، پردازنده، شبکه، حافظه، سیستمهای رک، نرمافزار و ابزارهای توسعه را ارائه میکند.
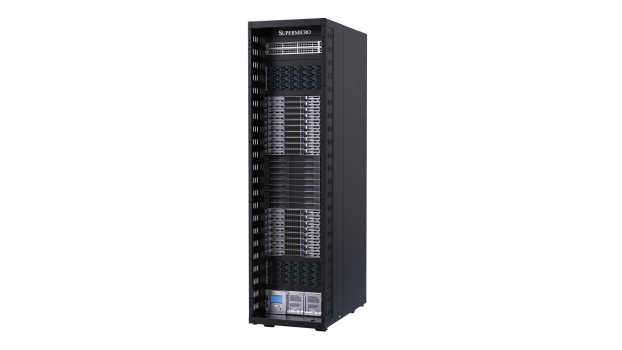
برای نمونه، GB300 NVL72 یک سیستم رکمحور شامل ۷۲ GPU از خانواده Blackwell Ultra و ۳۶ پردازنده Grace است. این سیستم برای بارهای استنتاج و مدلهای reasoning طراحی شده و NVIDIA آن را بهعنوان یک پلتفرم کامل AI معرفی میکند.
در نسل Blackwell Ultra، تمرکز NVIDIA بیش از گذشته روی کاهش هزینه اجرای مدل است. خود شرکت با استناد به معیارهای SemiAnalysis اعلام کرده است که سیستمهای Blackwell Ultra میتوانند در برخی بارهای کاری استنتاج، نسبت به Hopper تا ۳۵ برابر هزینه بهازای توکن کمتری داشته باشند.
این نکته مهم است: NVIDIA الزاماً مجبور نیست قیمت GPU را بهشدت کاهش دهد؛ اگر نسل جدید بتواند با همان هزینه سختافزاری، تعداد بسیار بیشتری توکن تولید کند، هزینه نهایی استفاده از AI کاهش پیدا میکند.
مزیت بزرگ NVIDIA چیست؟
یکی از مهمترین داراییهای NVIDIA اکوسیستم نرمافزاری آن است.
CUDA، TensorRT، NIM، ابزارهای مدیریت و کتابخانههای متعدد باعث شدهاند بسیاری از شرکتها زیرساخت خود را حول محصولات NVIDIA طراحی کنند.
این موضوع برای AMD و Google یک چالش جدی ایجاد میکند؛ زیرا خریدار فقط قیمت تراشه را مقایسه نمیکند. هزینه مهاجرت نرمافزار، بهینهسازی مدل و آموزش نیروی متخصص نیز در تصمیم نهایی تأثیر دارد.
 AMD؛ فشار قیمتی از مسیر حافظه و هزینه سختافزار
 AMD؛ فشار قیمتی از مسیر حافظه و هزینه سختافزار
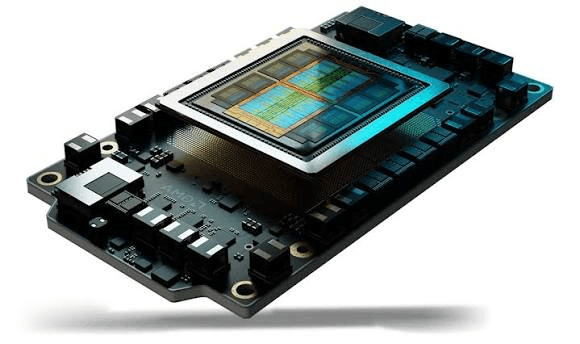
AMD مسیر متفاوتی را دنبال میکند. خانواده Instinct MI350 یکی از مهمترین تلاشهای این شرکت برای رقابت مستقیمتر با شتابدهندههای قدرتمند NVIDIA است.
MI350X میتواند تا ۲۸۸ گیگابایت HBM3E و حدود ۸ ترابایت بر ثانیه پهنای باند حافظه ارائه کند. AMD همچنین روی ROCm و بازتر بودن اکوسیستم نرمافزاری خود نسبت به راهکارهای کاملاً وابسته به CUDA تأکید دارد.
این مقدار حافظه یک مزیت مهم برای مدلهای بزرگ است. اگر یک مدل بتواند روی تعداد کمتری شتابدهنده قرار بگیرد، ممکن است نیاز به ارتباط بین GPUها کاهش پیدا کند و بخشی از هزینه زیرساخت پایین بیاید.
برای مثال، اگر یک مدل به حافظه بسیار زیادی نیاز داشته باشد، تعداد GPU موردنیاز فقط به قدرت پردازشی بستگی ندارد؛ ظرفیت HBM نیز میتواند تعیینکننده باشد.
AMD چگونه قیمت را وارد رقابت میکند؟
AMD در بسیاری از موارد تلاش میکند بهجای رقابت صرفاً بر سر «قویترین تراشه»، روی عملکرد به ازای دلار تمرکز کند.
این شرکت در برخی آزمایشهای منتشرشده توسط خودش، عملکرد MI350P را از نظر throughput به ازای هزینه با محصولات NVIDIA مقایسه کرده است؛ البته این نتایج توسط AMD انجام شدهاند و خود شرکت نیز تأکید میکند که نتیجه واقعی بسته به پیکربندی سیستم و نرمافزار متفاوت خواهد بود.
بنابراین هنگام خواندن ادعاهای «ارزانتر بودن AMD» باید دقت کرد که قیمت یک GPU بهتنهایی با هزینه واقعی یک سیستم AI برابر نیست.
Google؛ مدل متفاوت جنگ قیمتی با TPU
Google شاید متفاوتترین بازیگر این رقابت باشد.
این شرکت مانند NVIDIA صرفاً یک تراشه را برای فروش عمومی عرضه نمیکند. Google از TPUهای خودش در Google Cloud و محصولات داخلی استفاده میکند و بنابراین میتواند سختافزار، نرمافزار، شبکه و دیتاسنتر را از ابتدا با یکدیگر طراحی کند.
نسل هفتم TPU با نام Ironwood نمونه خوبی از این رویکرد است.
Ironwood در هر تراشه ۱۹۲ گیگابایت HBM دارد و پهنای باند حافظه آن حدود ۷.۳۷ ترابایت بر ثانیه است. سیستم TPU7x نیز میتواند تا ۹۲۱۶ تراشه را در یک Pod در کنار هم قرار دهد.
Google همچنین Ironwood را از ابتدا با تمرکز ویژه بر استنتاج طراحی کرده است؛ حوزهای که با افزایش استفاده روزمره از چتباتها و agentهای هوش مصنوعی اهمیت بیشتری پیدا کرده است.
قیمت واقعی Google TPU چقدر است؟
اینجا رقابت جالبتر میشود.
Google Cloud اکنون قیمت عمومی Ironwood را اعلام کرده است. قیمت On-Demand در منطقه us-central1 برابر با ۱۲ دلار به ازای هر تراشه در ساعت است و در لندن به ۱۳.۲۰ دلار میرسد.
در قرارداد سهساله، قیمت اعلامشده برای Iowa به ۵.۴۰ دلار به ازای تراشه در ساعت کاهش مییابد.
این اعداد البته مستقیماً با قیمت یک GPU NVIDIA قابل مقایسه نیستند، زیرا نوع سرویس، معماری سیستم، تعداد تراشهها، شبکه و نرمافزار متفاوت است.
اما انتشار چنین قیمتهایی نشان میدهد رقابت به مرحلهای رسیده که مشتری میتواند هزینه زیرساخت TPU را مستقیماً وارد محاسبات اقتصادی خود کند.
 Ironwood در برابر Blackwell؛ رقابت هزینه هر توکن
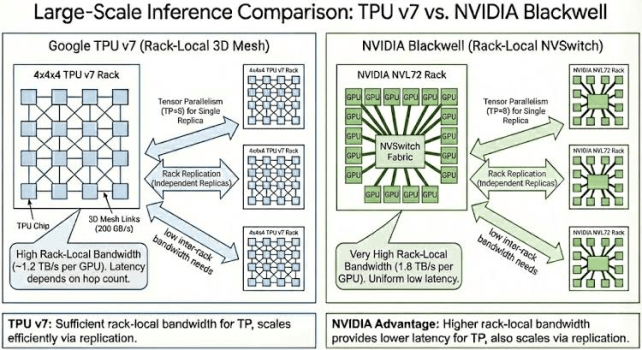 Ironwood در برابر Blackwell؛ رقابت هزینه هر توکن
یکی از جالبترین تحولات ۲۰۲۶، انتشار نتایج مستقلتر درباره هزینه اجرای مدلها روی Ironwood در مقایسه با Blackwell است.
در یک آزمون منتشرشده توسط SemiAnalysis و گزارشهای مرتبط با آن، Ironwood در یک سناریوی استنتاج با سرعت ۱۰۰ توکن در ثانیه به حدود ۰.۱۸۱ دلار به ازای یک میلیون توکن رسید؛ رقم گزارششده برای NVIDIA B200 حدود ۰.۲۲۲ دلار و برای B300 حدود ۰.۲۷۶ دلار بود. این نتایج به یک workload و تنظیمات مشخص مربوط هستند و نباید بهعنوان نتیجه قطعی برای تمام مدلها در نظر گرفته شوند.
اهمیت این آزمایش بیشتر از خود اعداد است.
تا همین چند سال پیش، مزیت NVIDIA در AI آنقدر بزرگ بود که بسیاری از مشتریان اساساً گزینههای جایگزین محدودی داشتند. اکنون Google میتواند در برخی بارهای استنتاجی، اقتصاد اجرای مدل را مستقیماً به چالش بکشد.
آیا Google واقعاً میخواهد NVIDIA را شکست دهد؟
موضوع کمی پیچیدهتر است.
Google علاوه بر TPU، در Google Cloud همچنان GPUهای NVIDIA را نیز عرضه میکند. Alphabet در گزارشهای خود اعلام کرده که Google Cloud مجموعهای از گزینههای محاسباتی، از TPUهای اختصاصی تا GPUهای NVIDIA، ارائه میدهد.
بنابراین هدف Google الزاماً حذف NVIDIA از بازار نیست.
مدل کسبوکار Google اجازه میدهد مشتری بسته به نوع workload، از TPU یا GPU استفاده کند.
این موضوع برای Google یک مزیت است: اگر TPU در یک workload اقتصادیتر باشد، Google میتواند همان ظرفیت را در اکوسیستم Cloud خودش ارائه کند؛ اگر مشتری به CUDA یا یک GPU خاص نیاز داشته باشد، Google Cloud همچنان میتواند GPU ارائه کند.
چرا AMD هنوز در این رقابت اهمیت زیادی دارد؟
AMD یک مزیت مهم دیگر دارد: بازار به دنبال تنوع تأمینکنندگان است.
شرکتهای بزرگ نمیخواهند تمام زیرساخت AI خود را به یک تأمینکننده وابسته کنند. دلایل این موضوع شامل موارد زیر است:
- محدودیت ظرفیت تولید
- قیمت
- دسترسی به GPU
- مصرف برق
- ریسک زنجیره تأمین
- هزینه نرمافزار
- وابستگی به یک اکوسیستم
- قدرت چانهزنی در قراردادهای بزرگ
در چنین شرایطی حتی اگر NVIDIA از نظر نرمافزار یا عملکرد کلی برای یک workload مشخص انتخاب اول یک شرکت باشد، وجود AMD و Google میتواند قدرت چانهزنی مشتری را افزایش دهد.
به بیان دیگر، رقیب ارزانتر لزوماً مجبور نیست بیشترین سهم بازار را به دست آورد تا روی قیمت بازار تأثیر بگذارد.
مقایسه سه رویکرد
| شرکت | راهکار اصلی | محور رقابت | مدل عرضه |
|---|---|---|---|
| NVIDIA | Blackwell / Blackwell Ultra | عملکرد، اکوسیستم و هزینه هر توکن | فروش سیستم، GPU و خدمات ابری |
| AMD | Instinct MI350 | حافظه، عملکرد به ازای دلار و ROCm | فروش GPU و سیستم به OEMها و Cloudها |
| TPU Ironwood | بهینهسازی کل سیستم و هزینه استنتاج | عمدتاً از طریق Google Cloud و زیرساخت داخلی |
این جدول نشان میدهد که این سه شرکت دقیقاً با یک مدل اقتصادی یکسان رقابت نمیکنند.
جنگ واقعی بر سر «قیمت چیپ» نیست
یکی از اشتباهات رایج در تحلیل این بازار، مقایسه قیمت یک تراشه با تراشه دیگر است.
فرض کنیم یک شتابدهنده ۲۰ درصد ارزانتر باشد. اگر برای اجرای همان مدل به تعداد بیشتری از آن نیاز باشد، یا ارتباط بین تراشهها هزینه بیشتری ایجاد کند، صرفهجویی اولیه ممکن است از بین برود.
هزینه واقعی یک سیستم AI شامل بخشهای بسیار بیشتری است:
قیمت تراشه + حافظه + سرور + شبکه + برق + خنکسازی + نرمافزار + نگهداری + هزینه استفاده از ظرفیت
به همین دلیل معیار مهمتر، TCO یا Total Cost of Ownership است.
حافظه HBM به یکی از میدانهای اصلی رقابت تبدیل شده است
یکی از عوامل مهم در قیمت شتابدهندههای جدید، حافظه HBM است.
مدلهای بزرگ AI حجم عظیمی از داده را جابهجا میکنند و افزایش ظرفیت و پهنای باند HBM میتواند مستقیماً روی عملکرد اثر بگذارد.
در این زمینه، AMD MI350 با ۲۸۸ گیگابایت HBM3E و Ironwood با ۱۹۲ گیگابایت HBM3E، نشان میدهند که رقابت فقط روی تعداد هستههای پردازشی نیست.
NVIDIA نیز در سیستمهای Blackwell Ultra از ظرفیت حافظه بسیار بالا در سطح سیستم استفاده میکند؛ برای مثال DGX B300 با هشت GPU در مجموع ۲.۱ ترابایت حافظه GPU دارد.
بنابراین افزایش قیمت یا محدودیت عرضه HBM میتواند به جای کاهش قیمت چیپها، حتی فشار صعودی بر هزینه کل سیستم ایجاد کند.
 نرمافزار میتواند ارزانترین چیپ را گرانترین انتخاب کند
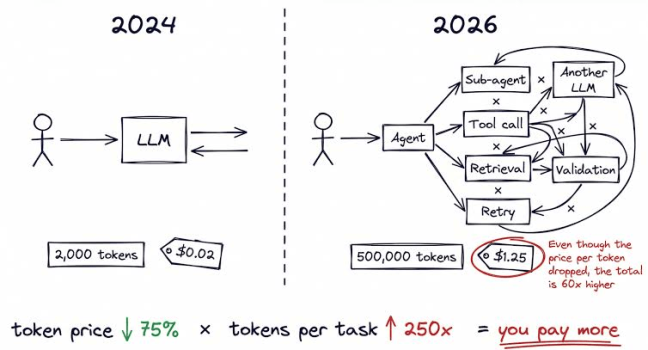 نرمافزار میتواند ارزانترین چیپ را گرانترین انتخاب کند
فرض کنیم AMD یا Google در یک آزمایش مشخص عملکرد بیشتری به ازای هر دلار ارائه دهد.
باز هم سؤال مهم این است:
آیا نرمافزار موجود شرکت روی آن سختافزار به همان اندازه بهینه است؟
برای شرکتی که سالها روی CUDA سرمایهگذاری کرده، انتقال یک مدل بزرگ به پلتفرم دیگر میتواند شامل:
- تغییر کد
- تست مجدد
- بهینهسازی Kernelها
- تغییر ابزارهای استقرار
- آموزش تیم
- تست پایداری
- ارزیابی عملکرد
باشد.
به همین دلیل NVIDIA از یک مزیت اقتصادی مهم برخوردار است که در قیمت رسمی GPU دیده نمیشود: هزینه جابهجایی از اکوسیستم آن.
در مقابل، AMD با ROCm و Google با ابزارهای مخصوص TPU تلاش میکنند این مانع را کاهش دهند.
Google یک مزیت مهم دارد: کنترل کل زنجیره
Google یکی از معدود شرکتهایی است که میتواند تقریباً تمام زنجیره را خودش طراحی کند:
مدل Gemini ← نرمافزار ← TPU ← شبکه ← دیتاسنتر ← Google Cloud
این یکپارچگی میتواند باعث شود Google برای workloadهایی که دقیقاً با TPU هماهنگ شدهاند، بهینهسازی بسیار عمیقی انجام دهد.
Ironwood نیز دقیقاً با همین فلسفه طراحی شده و Google آن را نه بهعنوان یک تراشه منفرد، بلکه بهعنوان بخشی از یک سیستم بسیار بزرگ معرفی میکند.
آیا این رقابت باعث کاهش قیمت برای کاربران میشود؟
احتمالاً اثر اصلی رقابت در کوتاهمدت الزاماً کاهش مستقیم قیمت GPU نخواهد بود.
رقابت ممکن است ابتدا از مسیرهای دیگری خود را نشان دهد:
- افزایش عملکرد در هر نسل
- کاهش هزینه هر توکن
- افزایش حافظه بدون افزایش متناسب قیمت
- مصرف برق کمتر
- قراردادهای بلندمدت ارزانتر
- تخفیفهای Cloud
- افزایش گزینههای اجاره GPU
- ارائه ظرفیت بیشتر برای مشتریان بزرگ
برای نمونه، Google در قیمتگذاری Ironwood تفاوت قابلتوجهی بین استفاده On-Demand و قراردادهای یکساله و سهساله دارد.
بنابراین مشتریان بزرگ میتوانند از مدلهای قراردادی برای پایین آوردن هزینه واقعی استفاده کنند.
NVIDIA چه چیزی برای دفاع از موقعیت خود دارد؟
NVIDIA فقط روی قدرت سختافزاری حساب نمیکند.
این شرکت همزمان روی چند لایه سرمایهگذاری کرده است:
GPU ← NVLink ← شبکه ← TensorRT ← CUDA ← NIM ← سیستمهای DGX ← نرمافزار مدیریت دیتاسنتر
این استراتژی باعث میشود مقایسه NVIDIA با AMD یا Google فقط مقایسه یک تراشه نباشد.
حتی اگر یک رقیب در یک benchmark خاص عملکرد بهتری داشته باشد، NVIDIA میتواند با بهینهسازی نرمافزار، شبکه و معماری سیستم، هزینه نهایی اجرای workload را کاهش دهد.
AMD برای گرفتن سهم بیشتر به چه چیزی نیاز دارد؟
برای AMD، افزایش قدرت سختافزاری بهتنهایی کافی نیست.
سه موضوع اهمیت زیادی دارند:
رشد ROCm
هرچه پشتیبانی ROCm از مدلها، کتابخانهها و ابزارهای محبوب بهتر شود، هزینه مهاجرت از CUDA کاهش پیدا میکند.
عرضه پایدار
مشتری دیتاسنتر به تراشهای نیاز دارد که بتواند در حجم بالا دریافت کند. ظرفیت تولید و زنجیره تأمین بنابراین به اندازه benchmark اهمیت دارند.
قیمتگذاری رقابتی
اگر AMD بتواند عملکرد و حافظه بالایی را با هزینه سیستم پایینتر ارائه کند، مشتریان بیشتری انگیزه بررسی آن را خواهند داشت.
Google چه محدودیتی دارد؟
TPU یک مزیت مهم دارد، اما همان مزیت میتواند محدودیت نیز ایجاد کند.
TPU بیش از GPU به اکوسیستم Google وابسته است و بسیاری از شرکتها ممکن است انعطافپذیری GPUهای عمومیتر را ترجیح دهند.
از طرف دیگر، Google Cloud تنها مسیر اصلی دسترسی مشتریان خارجی به TPU است. در نتیجه شرکتی که میخواهد سختافزار را در دیتاسنتر خودش نصب و مدیریت کند، انتخابهای متفاوتی نسبت به مشتری Google Cloud دارد.
بنابراین موفقیت Ironwood الزاماً به معنی جایگزین شدن آن با GPUهای NVIDIA در همه بازارها نیست.
آینده جنگ قیمتی چگونه خواهد بود؟
رقابت احتمالاً از «قیمت یک چیپ» به سمت هزینه هر واحد کار مفید حرکت خواهد کرد.
برای مدلهای استنتاجی، این واحد میتواند میلیون توکن باشد.
برای آموزش، ممکن است زمان لازم برای رسیدن به یک loss مشخص یا هزینه آموزش یک مدل باشد.
برای agentهای هوش مصنوعی نیز معیار میتواند هزینه تکمیل یک وظیفه کامل باشد، نه فقط قیمت هر توکن.
این تغییر اهمیت زیادی دارد؛ زیرا یک شتابدهنده گرانتر اگر بتواند یک وظیفه را بسیار سریعتر انجام دهد، ممکن است در نهایت ارزانتر از سختافزار ارزانتر باشد.
جمعبندی
رقابت NVIDIA، AMD و Google در سال ۲۰۲۶ را نمیتوان صرفاً یک جنگ قیمت چیپهای هوش مصنوعی دانست.
NVIDIA با Blackwell و Blackwell Ultra تلاش میکند از طریق یکپارچهسازی سختافزار و نرمافزار، هزینه اجرای مدل را پایین بیاورد. AMD با Instinct MI350 روی حافظه بسیار بالا، ROCm و عملکرد به ازای هزینه تمرکز کرده است. Google نیز با TPU Ironwood و کنترل کاملتر روی سختافزار، نرمافزار و دیتاسنتر، مدل متفاوتی برای کاهش هزینه AI ارائه میدهد.
در نهایت، برنده هر قرارداد لزوماً ارزانترین تراشه را ندارد. معیار مهمتر این است که یک سیستم با چه هزینهای میتواند مقدار مشخصی کار مفید هوش مصنوعی انجام دهد.
به همین دلیل احتمالاً در سالهای آینده اصطلاحاتی مانند هزینه هر میلیون توکن، عملکرد به ازای وات و TCO برای بازار چیپهای AI مهمتر از قیمت خام یک GPU خواهند شد.